Тестване на план за възстановяване без риск
Неуспешното възстановяване рядко започва в момента на инцидента. Обикновено причината е много по-ранна: архивите не са проверявани, отговорностите са неясни, достъпите до критични системи не са актуални или планът е останал само документ в папка. Затова тестването на план за възстановяване не е формално IT упражнение, а контрол върху способността на организацията да продължи работа след кибератака, техническа повреда, човешка грешка или загуба на основна инфраструктура.
За управителя въпросът не е дали разполагате с резервни копия. Въпросът е дали можете да възстановите конкретните данни, приложения и процеси в срок, който бизнесът може да понесе. Разликата между двете често определя дали прекъсването ще бъде неудобство или съществен финансов, договорен и регулаторен проблем.
Какво доказва тестът на плана за възстановяване
Планът за възстановяване при бедствие и инцидент, често означаван като Disaster Recovery Plan, описва действията при отпадане на системи и данни. Тестът доказва дали тези действия са изпълними в реална среда. Той не следва да се ограничава с проверка дали даден архивен файл съществува. Необходимо е да се установи дали файлът е четим, дали данните са пълни, дали приложението стартира с тях и дали упълномощените служители могат да извършат критичните операции.
Това разграничение е особено съществено при ERP, счетоводни системи, платформи за управление на документи, CRM, електронна поща и файлови хранилища. Една база данни може да бъде технически възстановена, но ако липсват конфигурации, лицензи, ключове за криптиране, връзки към други системи или актуална документация, бизнес процесът остава блокиран.
Добре проведеното тестване дава измерим отговор на три въпроса: какво може да се възстанови, за колко време и с каква загуба на данни. Тези отговори трябва да бъдат разбираеми и за ръководството, не само за IT екипа.
RTO и RPO: параметрите, които правят плана управляем
Два показателя задават рамката на всяко реалистично възстановяване. RTO, или Recovery Time Objective, е допустимото време за възстановяване на дадена система. RPO, или Recovery Point Objective, определя приемливата загуба на данни, измерена във времето.
Например организация може да приеме, че вътрешният файлов архив може да бъде недостъпен до 24 часа, но системата за издаване на фактури трябва да бъде работоспособна до четири часа. При RPO от един час последният възстановим архив не трябва да е по-стар от един час. Ако резервното копиране се изпълнява веднъж дневно, това изискване очевидно не е покрито.
Стойностите не бива да се определят само от техническите възможности или от цената на услугата. Те зависят от договорни ангажименти, финансови операции, чувствителността на обработваните лични данни, сроковете към клиенти и възможността за ръчна работа при отпадане на система. По-строгите цели изискват по-чести копия, резервирана инфраструктура и повече организационна подготовка. Това е инвестиция, която трябва да бъде съобразена с реалната цена на прекъсването.
Как да организирате тестване на план за възстановяване
Най-полезният тест започва с ограничен, но представителен сценарий. Вместо да се симулира едновременно отпадане на цялата организация, може да се избере критична система и конкретен инцидент: криптиране на файлов сървър, повреда на база данни, изтриване на папка с договори или недостъпност на основната виртуална среда. Целта е да се премине през реалните стъпки без да се застрашава текущата работа.
Определете обхвата и критичността
Първата задача е да се опише какво точно ще бъде възстановявано: сървър, база данни, документално хранилище, работни станции или цял бизнес процес. За всяка система трябва да има собственик от бизнеса, технически отговорник, допустими RTO и RPO, зависимости и критерии за успешен резултат.
Зависимостите често са подценявани. Приложение може да има нужда от DNS услуга, мрежова свързаност, Active Directory, сертификати, виртуална среда, външен доставчик или специфичен потребителски достъп. Ако те не присъстват в сценария, тестът може да даде подвеждащо добра оценка.
Проверете архивите извън продукционната среда
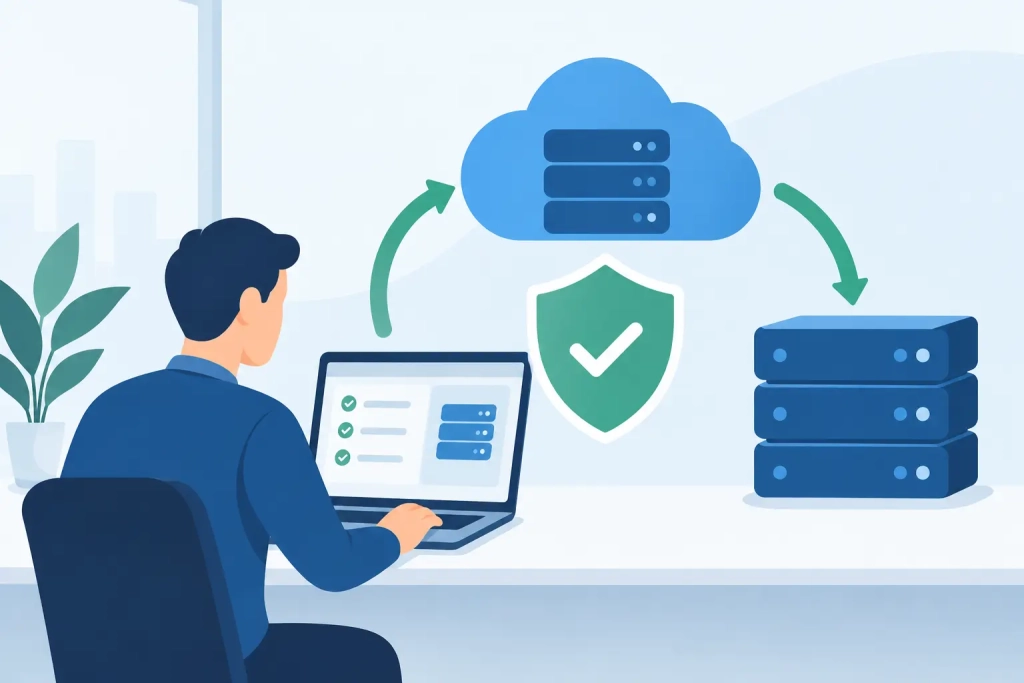
Възстановяването следва да се извърши в изолирана тестова среда, когато това е възможно. Така се избягва рискът от презаписване на актуални данни и се проверява дали архивът е самостоятелно използваем. При сценарий с рансъмуер тази практика е критична: не е достатъчно да се върнат данните, трябва да има увереност, че възстановената среда не съдържа компрометирани файлове или механизъм за повторно заразяване.
Проверете дали се възстановяват не само данните, но и структурата на папките, правата за достъп, версиите на приложенията, конфигурациите и журналите, които са нужни за разследване. При криптирани архиви тествайте и наличността на ключовете за декриптиране. Ключ, съхраняван единствено в недостъпна система, може да обезсмисли иначе качественото архивиране.
Измерете време, качество и ръчни действия
По време на теста записвайте началния и крайния час за всяка стъпка. Отделете автоматизираното възстановяване от действията, които изискват човек: одобрение, извличане на достъп, промяна на мрежови настройки, комуникация с доставчик или проверка от собственик на процеса.
Успешният тест не означава само, че сървърът е стартирал. Необходимо е бизнес потребител да потвърди, че може да отвори нужните документи, да въведе операция, да генерира справка или да приключи работен процес. Тази проверка е решаваща при системи, които поддържат финансови, кадрови, договорни или клиентски данни.
Документирайте отклоненията и подобренията
След теста подгответе кратък протокол с обхват, дата, участници, сценарий, постигнати RTO и RPO, резултати и открити несъответствия. За всяко отклонение трябва да има собственик, срок и конкретно коригиращо действие. Това може да бъде промяна в графика за архивиране, допълване на инструкция, ограничаване на прекомерни права за достъп или добавяне на второ място за съхранение.
Документацията има стойност и извън оперативния контрол. Тя подкрепя изискванията за отчетност по GDPR, управлението на риска по ISO 27001 и доказването на прилагани мерки за непрекъсваемост. За организации в обхвата на NIS2 или DORA редовните тестове и проследимото отстраняване на слабости са логична част от дисциплината по управление на киберриска.
Кои сценарии трябва да присъстват в програмата за тестове
Един годишен тест на произволен архив не е достатъчен за системи с висока критичност. Програмата трябва да се съобрази с риска и да включва различни ситуации. Практично е да се планират поне следните сценарии:
- възстановяване на отделен файл, папка или електронен документ след грешно изтриване;
- възстановяване на база данни и проверка на приложението, което я използва;
- възстановяване на цял виртуален сървър или критична работна станция;
- реакция при рансъмуер, включително проверка на чиста точка за възстановяване;
- отпадане на основната локация, интернет свързаност или ключов облачен компонент;
- недостъпност на служител с критични знания, администраторски права или достъп до ключове.
Честотата зависи от динамиката на средата. При чести промени по приложения, инфраструктура или персонал тестовете трябва да са по-чести. След голяма миграция, внедряване на нова система, промяна на доставчик или инцидент е разумно да се направи извънредна проверка, а не да се чака следващият планиран период.
Чести пропуски, които тестът разкрива
Най-рисковият пропуск е да се предполага, че успешно изпълненият backup job означава успешно възстановяване. Системата за архивиране може да отчете приключена задача, докато съдържанието е непълно, повредено или не включва нужните компоненти.
Друг често срещан проблем е зависимостта от един човек. Ако само един администратор знае паролите, местоположението на архивите или последователността за възстановяване, организацията няма устойчив план. Затова ролите, контактите, процедурите за ескалация и защитеният достъп до критични данни трябва да се поддържат актуални.
Риск представлява и архивиране към среда, която е постоянно достъпна със същите администраторски идентификационни данни като продукционната. При компрометиране на тези права атакуващият може да засегне и основните данни, и копията им. Изолирано съхранение, контрол на достъпа, криптиране и подходяща неизменяемост на копията намаляват тази опасност, но и те трябва да бъдат проверявани на практика.
От технически тест към устойчива организационна практика
Възстановяването е едновременно технологичен и управленски процес. IT екипът или външният партньор могат да възстановят инфраструктурата, но ръководството трябва предварително да е определило кое се връща първо, кой взема решенията при инцидент и как се комуникира със служители, клиенти и регулатори при необходимост.
За малки и средни организации най-работещият подход често е комбинация от надеждно архивиране, ясно приоритизирани системи, кратки практически инструкции и периодични тестове с документирани резултати. Буллсофт може да подпомогне този процес чрез свързване на резервното копиране и възстановяването с регистрите на риска, изискванията за съответствие и реалните зависимости в работата на организацията.
Следващият тест не бива да чака инцидент или одит. Изберете една критична система, определете измерим сценарий и проверете възстановяването в контролирана среда. Получените данни ще покажат къде планът работи и къде е необходимо действие, докато все още разполагате с време за него.